HumanBench
Können KI-Modelle Gesichter so lesen wie Menschen? HumanBench lässt Modelle 26 Gesichtsmerkmale auf 14 Fotos bewerten – von der Augengröße bis zur Kinnlänge – und misst, wie nah sie an das Urteil erfahrener Profiler herankommen.
Rangliste · Profiler-Set
HumanBench Score: 100 Punkte erreicht der beste Mensch, 0 Punkte das schwächste Modell, das wir je getestet haben (Gemini (2025)). Die gestrichelte Linie ist die Human Baseline – der Durchschnitt aller Menschen. Zum Vergleich: Wer bei jedem Merkmal nur den Durchschnittswert rät, landet bei 45,9 Punkten. Fahre über einen Balken für Details.
| # | Modell / Gruppe | Anbieter | Setup | Score | Ø Abweichung | ±0,5 | ±1,0 | ≥2 |
|---|---|---|---|---|---|---|---|---|
| 1 | Bester Mensch | Profiler | Profiler | 100,0 | 0,26 | 88 % | 99 % | 0,0 % |
| 2 | Human Baseline | Mensch | Ø aller Menschen | 88,3 | 0,37 | 78 % | 96 % | 0,3 % |
| 3 | Claude Opus 5.5 | Anthropic | Mit Harness | 71,8 | 0,51 | 58 % | 87 % | 0,8 % |
| 4 | GPT-6 Astra | OpenAI | Mit Harness | 68,4 | 0,54 | 59 % | 87 % | 1,1 % |
| 5 | GPT-6.1 Sol | OpenAI | Mit Harness | 66,0 | 0,56 | 57 % | 85 % | 1,1 % |
| 6 | Claude Sonnet 5.5 | Anthropic | Mit Harness | 62,2 | 0,60 | 50 % | 83 % | 1,7 % |
| 7 | Claude Haiku 5.5 | Anthropic | Mit Harness | 61,7 | 0,60 | 55 % | 83 % | 1,9 % |
| 8 | Claude Opus 5.5 | Anthropic | Zero-Shot | 50,6 | 0,70 | 45 % | 76 % | 3,3 % |
| 9 | Raten (Merkmals-Durchschnitt) | Baseline | Referenz | 45,9 | 0,74 | 38 % | 73 % | 1,4 % |
| 10 | Claude 3.7 Sonnet | Anthropic | Archiv 2025 | 41,7 | 0,78 | 44 % | 75 % | 5,0 % |
| 11 | Claude Sonnet 5.5 | Anthropic | Zero-Shot | 41,3 | 0,78 | 45 % | 73 % | 6,1 % |
| 12 | Claude Sonnet 4.5 | Anthropic | Archiv 2025 | 39,2 | 0,80 | 46 % | 73 % | 6,3 % |
| 13 | Claude Haiku 5.5 | Anthropic | Zero-Shot | 38,2 | 0,81 | 45 % | 69 % | 9,0 % |
| 14 | GPT-6 Astra | OpenAI | Zero-Shot | 35,6 | 0,83 | 45 % | 73 % | 9,1 % |
| 15 | GPT-6.1 Sol | OpenAI | Zero-Shot | 29,5 | 0,89 | 41 % | 70 % | 10,2 % |
| 16 | ChatGPT (2025) | OpenAI | Archiv 2025 | 12,5 | 1,04 | 32 % | 59 % | 13,2 % |
| 17 | Gemini (2025) | Archiv 2025 | 0,0 | 1,15 | 28 % | 53 % | 17,4 % |
Wo die Modelle danebenliegen
Durchschnittliche Abweichung je Merkmal (Skala 1 bis 8). Geometrische Merkmale wie Augengröße oder Kinnlänge gelingen mit Vermessung gut; Merkmale wie Jochbeine, Nasenwurzel oder Festigkeitsachse treffen die Modelle kaum besser als Raten.
| Merkmal | Human Baseline | Opus 5.5 Harness | GPT-6.1 Sol Harness | Opus 5.5 Zero-Shot | GPT-6.1 Sol Zero-Shot |
|---|---|---|---|---|---|
| Jochbeine | 0,32 | 0,87 | 0,86 | 0,66 | 0,82 |
| Nasenwurzel | 0,33 | 0,64 | 0,63 | 0,83 | 0,56 |
| Oberstirnvolumen | 0,32 | 0,63 | 0,62 | 0,59 | 0,60 |
| Festigkeitsachse | 0,34 | 0,63 | 0,65 | 0,90 | 1,21 |
| Oberlippenschwung | 0,47 | 0,62 | 0,89 | 0,62 | 1,47 |
| Nasenrückenbreite | 0,42 | 0,61 | 0,83 | 0,82 | 0,95 |
| Ohrabstand | 0,18 | 0,61 | 0,71 | 1,28 | 1,25 |
| Nasenflügel | 0,41 | 0,59 | 0,65 | 0,53 | 0,77 |
| Nasenseitenwand (Nasendach) | 0,38 | 0,55 | 0,60 | 0,59 | 0,74 |
| Nasenspitze | 0,29 | 0,54 | 0,59 | 0,99 | 2,93 |
| Tiefe Nasenspitze | 0,39 | 0,53 | 0,71 | 0,60 | 0,48 |
| Pallium | 0,36 | 0,52 | 0,55 | 0,81 | 0,44 |
| Naturell: Empfindung | 0,44 | 0,50 | 0,57 | 0,88 | 0,55 |
| Nasenlänge | 0,27 | 0,49 | 0,53 | 0,49 | 0,93 |
| V Augenbrauen | 0,36 | 0,47 | 0,50 | 0,77 | 1,04 |
| Naturell: Ernährung | 0,52 | 0,47 | 0,64 | 0,47 | 0,71 |
| Kinnlänge | 0,40 | 0,46 | 0,32 | 1,17 | 1,97 |
| Oberlippenvolumen | 0,31 | 0,46 | 0,41 | 0,59 | 0,85 |
| Mundgröße | 0,41 | 0,45 | 0,46 | 0,44 | 0,67 |
| Halsbreite | 0,39 | 0,42 | 0,52 | 0,76 | 0,68 |
| Kinn hervortretend | 0,37 | 0,42 | 0,41 | 0,41 | 0,44 |
| Unterkiefer | 0,31 | 0,41 | 0,45 | 0,57 | 0,53 |
| Naturell Bewegung | 0,40 | 0,40 | 0,44 | 0,56 | 0,59 |
| Kinnbreite | 0,42 | 0,39 | 0,40 | 0,79 | 0,51 |
| Augengröße | 0,36 | 0,38 | 0,33 | 0,74 | 0,84 |
| Unterstirnvolumen | 0,36 | 0,29 | 0,43 | 0,34 | 0,60 |
HumanBench Album
24 lizenzierte Porträts, gemischt nach Geschlecht, Alter und Herkunft. Hier ist die Referenz nicht ein kleines Profiler-Team, sondern der Durchschnitt aller Menschen, die das Album im Selbsttest bewerten. Die KI-Modelle haben jedes Foto bereits bewertet; ihre Rangliste erscheint, sobald genug menschliche Bewertungen vorliegen.
Die Album-Rangliste startet ab 100 bewerteten Kombinationen. 48 Bewertungen aus 2 Selbsttests bisher.
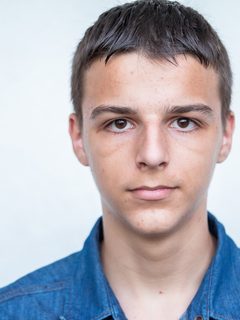
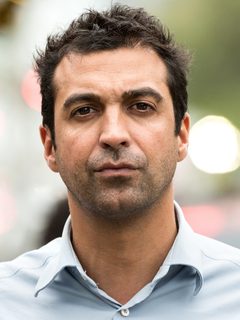
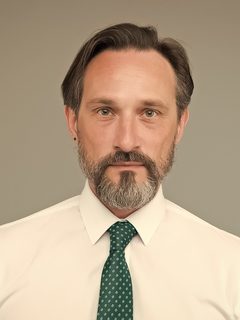
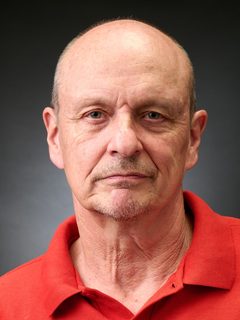
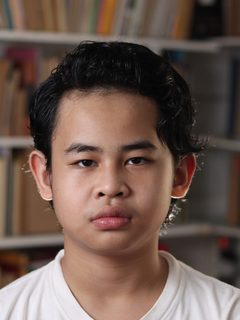
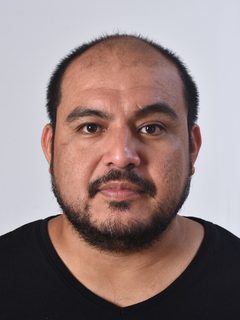
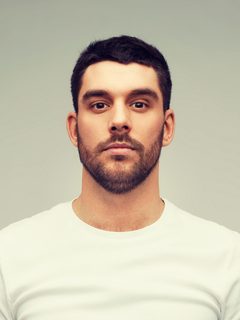
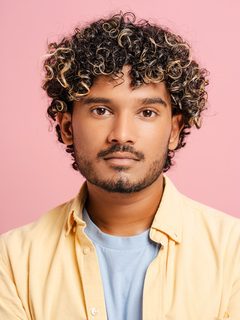
Fotos: Magnific (Urheber beim Darüberfahren und auf der jeweiligen Quellseite)
Teste dich selbst
Bewerte Fotos aus dem Album – dieselben Merkmale, die auch die Modelle bewerten. Deine Bewertungen bilden die menschliche Referenz des Albums.
Wie gut liest du Gesichter?
Du siehst drei Fotos aus dem HumanBench-Album und bewertest je acht Merkmale auf einer Skala von 1 bis 8 – genau wie die KI-Modelle. Danach erfährst du, wie nah du an der Einschätzung der anderen Teilnehmenden liegst. Dauer: etwa vier Minuten.
Methodik
- 14 Porträtfotos, 26 Merkmale, Skala 1 bis 8. Referenz ist der Durchschnitt von vier ausgebildeten Profilern (363 Werte).
- Ø Abweichung: mittlere absolute Differenz zur Referenz. Jeder Profiler wird fair gegen den Schnitt der jeweils anderen drei gemessen.
- Score: linear zwischen dem besten Menschen (0,26 Ø Abweichung = 100 Punkte) und dem schwächsten je getesteten Modell (1,15 = 0 Punkte). Die Human Baseline ist der Durchschnitt aller Menschen.
- Zero-Shot: Das Modell erhält ein Foto und die Merkmalsdefinitionen der Profiler.
- Mit Harness: zusätzlich exakte Vermessung (478 Gesichtspunkte) und Vergleichsbögen mit bewerteten Referenzgesichtern – stets ohne das getestete Gesicht selbst.
- Archiv 2025: Ergebnisse aus unseren früheren Tests mit älteren Prompt-Versionen; nur eingeschränkt vergleichbar.
- Album: Referenz ist der Durchschnitt aller Menschen je Foto und Merkmal (ab 5 Bewertungen). Menschen werden gegen den Durchschnitt der jeweils anderen gemessen; 100 Punkte erreicht der beste Teilnehmende (ab 15 vergleichbaren Bewertungen), 0 Punkte das schwächste Modell.
- Jedes Modell wurde einmal pro Gesicht abgefragt. Stand: 14. Oktober 2026.
Was HumanBench misst – und was nicht
HumanBench prüft, ob KI sichtbare Gesichtsmerkmale so einschätzt wie geschulte Menschen: eine Wahrnehmungsaufgabe. Es misst nicht, ob sich aus Gesichtern Persönlichkeit ablesen lässt. Bemerkenswert ist der Abstand: Selbst die besten Modelle liegen trotz aller Fortschritte deutlich hinter menschlichen Profilern, und ohne Hilfsmittel kaum über dem Raten.
Mit vier Profilern und 14 Gesichtern ist die Datenbasis noch klein. Deshalb sammeln wir über den Selbsttest weitere menschliche Bewertungen.